Как тестировать ИИ-агента перед запуском: чек-лист и типичные ошибки
Протестировать ИИ-агента перед запуском значит прогнать его на реальных примерах (обычно хватает от 20 до 50), проверить каждое из четырёх звеньев (модель, инструкция, инструменты и память) и убедиться, что на спорных случаях он отдаёт задачу человеку, а не выдумывает данные. Тестирование ИИ-агента отличается от проверки нейросети тем, что агент сам совершает действия в вашей CRM и мессенджерах, поэтому ошибка стоит дороже: она уходит прямо к клиенту.
Коротко о главном:
– Тестируйте агента на реальных заявках или документах, а не на выдуманных, и берите не меньше двух-трёх десятков примеров
– Проверяйте отдельно каждую из 4 частей: модель, инструкцию, инструменты и память
– Больше всего ошибок вылезает на спорных случаях, где агент должен спросить человека, а не решать сам
– В Альбато агента можно собрать и прогнать на тестовых данных без выпуска на реальных клиентов
– Критерий готовности к запуску: заданная метрика достигнута на выборке, а необратимые действия идут через подтверждение
Содержание:
→ Что значит протестировать ИИ-агента
→ Чек-лист тестирования перед запуском
→ Что проверять в каждой из 4 частей агента
→ Как собрать тестовую среду в Альбато
→ Типичные ошибки при тестировании
→ Когда агента можно выпускать в прод
Ниже разберём, что именно проверять на каждом шаге, как собрать тестовую среду в Альбато и какие ошибки чаще всего пропускают перед боевым запуском.
Что значит протестировать ИИ-агента
Протестировать ИИ-агента значит проверить не одну модель, а всю связку из четырёх частей на реальных данных до того, как агент начнёт работать с живыми клиентами. Обычную нейросеть проверяют просто: задали вопрос, посмотрели ответ. С агентом так нельзя, потому что он не просто отвечает текстом, а совершает действия: создаёт сделку в CRM, пишет клиенту в мессенджер, ставит задачу менеджеру.
ИИ-агент состоит из четырёх частей: модель (принимает решения), инструкция (описывает задачу), инструменты (действия в сервисах) и память (контекст между запусками). Полное определение и разбор компонентов есть в гайде про то, что такое ИИ-агент и из каких частей он состоит. Тестировать нужно каждую из них, потому что сбой в любом звене ломает результат: правильная модель с плохой инструкцией даст неверное действие, хорошая инструкция без нужного инструмента просто ничего не сделает.
Отсюда и главный принцип тестирования: воспроизвести реальный поток данных, а не подсунуть агенту идеальные примеры. Настоящие заявки бывают с опечатками, без части полей, с нестандартными формулировками. Именно на них агент и ошибается, а не на чистых учебных случаях.
Чек-лист тестирования ИИ-агента перед запуском
Тестирование удобно вести по чек-листу из семи шагов: от сбора тестовых данных до финального решения о запуске. Каждый шаг закрывает свой тип ошибок, поэтому пропускать их не стоит. Этот чек-лист дополняет базовую настройку: как собрать самого агента, разобрано в материале про то, как настроить ИИ-агента: чек-лист из 10 шагов.
- Соберите тестовую выборку. Возьмите от 20 до 50 реальных примеров из вашей практики: заявки, письма, документы, сообщения клиентов. Обязательно добавьте спорные и «грязные» случаи, а не только удобные.
- Задайте эталон. Для каждого примера заранее пропишите, какой результат считается правильным: какое действие агент должен совершить и какие поля заполнить.
- Прогоните агента на выборке. Запустите связку на всех примерах и соберите, что агент сделал на каждом.
- Сравните с эталоном. Отметьте, где агент попал, где ошибся, а где повёл себя неопределённо (сделал что-то на грани).
- Проверьте каждую из 4 частей. Разберите ошибки по звеньям: виновата модель, инструкция, инструмент или память (подробнее ниже).
- Проверьте поведение на спорных случаях. Убедитесь, что на непонятном примере агент останавливается и передаёт задачу человеку, а не действует наугад.
- Примите решение о запуске. Если метрика достигнута и необратимых ошибок нет, выпускайте поэтапно. Если нет, правьте инструкцию и повторяйте прогон.
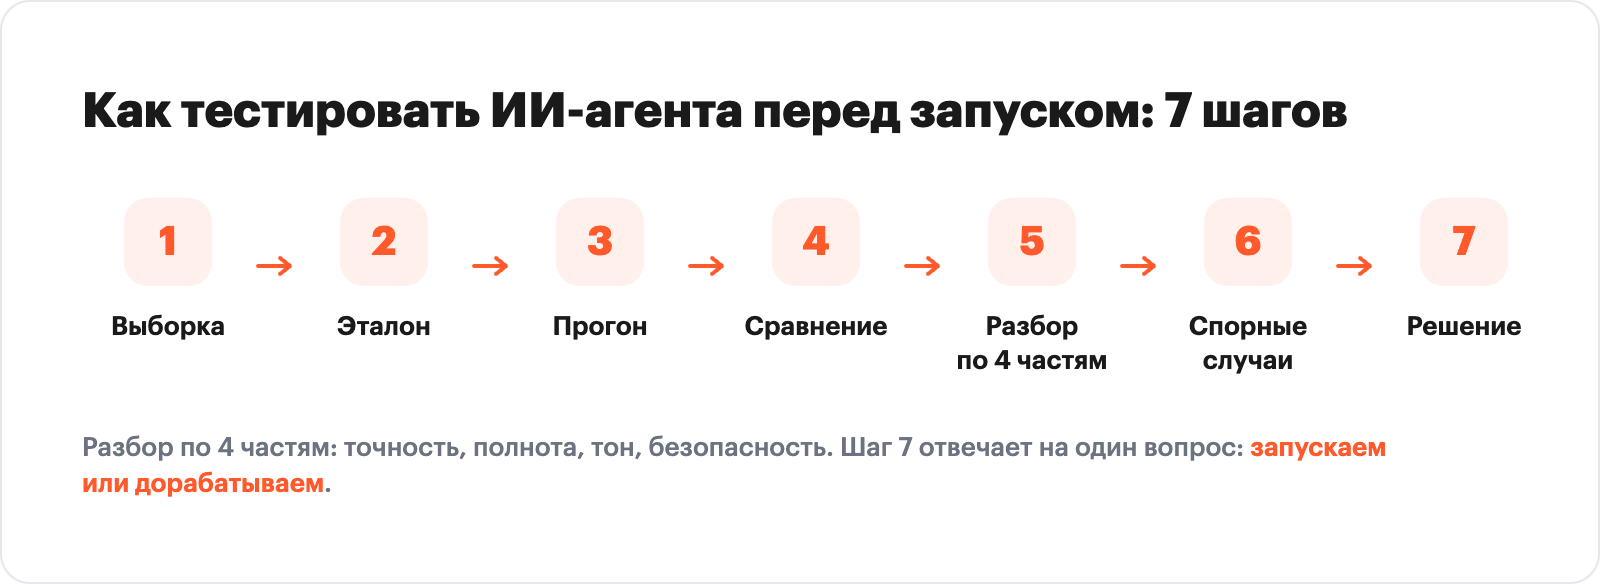
Порядок важен: без эталона (шаг 2) прогон бесполезен, потому что не с чем сравнивать. А без спорных случаев в выборке (шаг 1) вы проверите агента только там, где он и так справляется.
Что именно проверять в каждой из 4 частей агента
Ошибки агента почти всегда сводятся к одной из четырёх частей, поэтому разбор по звеньям экономит время: вы сразу видите, что чинить. Ниже что проверять в каждой части.
Модель
Модель отвечает за то, как агент понимает задачу и принимает решение. На тесте смотрите, стабильно ли он выбирает верное действие на похожих примерах. Если на двух почти одинаковых заявках агент ведёт себя по-разному, дело часто не в модели, а в размытой инструкции. Начать можно со встроенной модели Альбато AI, чтобы не подключать внешнюю LLM (большую языковую модель) на этапе проверки гипотезы.
Инструкция
Инструкция (промпт) описывает задачу и правила. Это самое частое место ошибок: агент делает не то, потому что задача сформулирована размыто. На тесте проверяйте, что в инструкции явно сказано, в каких случаях действовать, а в каких нет. Каждое поле в Альбато вмещает до 1 000 символов: сообщение пользователя, системные инструкции и ограничения. Как формулировать инструкцию так, чтобы агент понимал её однозначно, разобрано в статье про то, как писать промпт для ИИ-агента.
Инструменты
Инструменты это действия в сервисах, которые агент может вызвать: создать сделку, отправить сообщение, обновить строку в таблице. В Альбато доступно около 5 000 таких действий. На тесте проверьте, что агент вызывает нужный инструмент в нужный момент и правильно заполняет поля. Отдельно проверьте поля, где включена кнопка «Разрешить ИИ-агенту принять решение»: именно там агент подставляет значение сам, и там же чаще ошибается.
Память
Память хранит контекст между запусками и по умолчанию выключена. Если ваш сценарий её использует (например, чат-бот, который помнит предыдущие сообщения), проверьте, что агент не путает диалоги разных клиентов. За это отвечает ID треда: он разделяет память по пользователям. Объём памяти задаётся от 1 до 100 последних взаимодействий. Если агенту важны данные компании, а не только диалог, стоит проверить и базу знаний: как её подключить, описано в материале про то, как обучить агента на данных компании без дообучения.
Как собрать тестовую среду и прогнать агента в Альбато
В Альбато тестовую среду для агента можно собрать примерно за 20 минут без программирования и здесь же прогнать его на реальных данных до выпуска на клиентов. Важно, что Альбато закрывает обе половины задачи: вы и создаёте ИИ-агента в визуальном конструкторе, и подключаете его к amoCRM, Битрикс24, Telegram и другим сервисам из каталога 1 000+ коннекторов. Не нужен отдельный сервис агента плюс отдельная платформа интеграций.
Порядок сборки тестового прогона такой:
- Соберите связку как обычно: условие запуска, шаг ИИ-агента, инструкция, подключённые инструменты.
- На время теста направьте действия агента в безопасное место: тестовую воронку в CRM, отдельную таблицу в Google Sheets или тестовый чат в Telegram, а не в боевую систему.
- Прогоните через связку тестовую выборку: подайте на вход реальные заявки или документы по одному.
- Смотрите журнал агента: он показывает, куда агент обращался и как принимал решение на каждом шаге. По журналу видно, где именно связка ошиблась.
- Правьте инструкцию и ограничения по найденным ошибкам и повторяйте прогон, пока результат не станет стабильным.
Шаг агента в редакторе связки выглядит так.
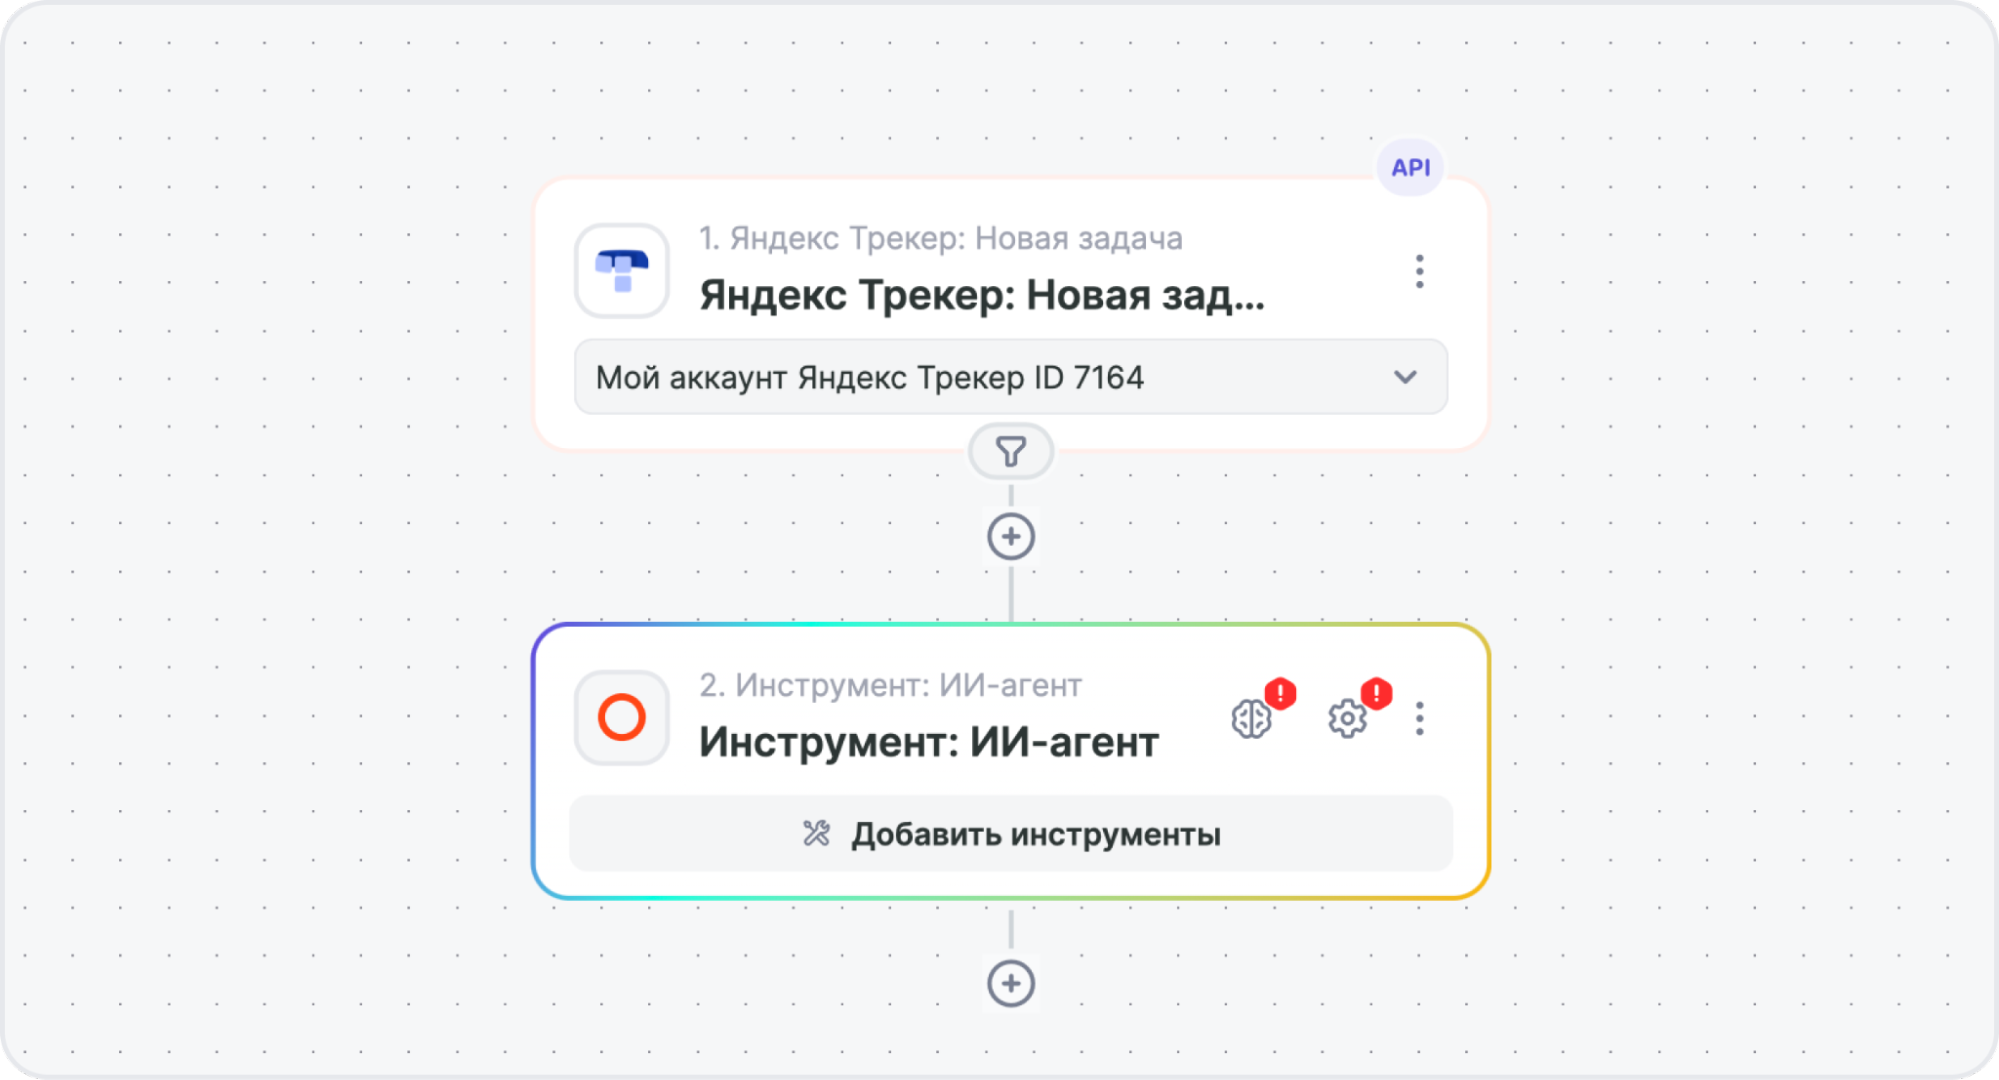
Журнал агента (логирование его шагов) это главный инструмент на тесте. Он показывает не только итог, но и ход рассуждения: куда агент постучался, что искал, где застрял. Например, видно, что агент пошёл в таблицу и долго искал значение, потому что его там не было. Без журнала вы видите только неверный результат, но не причину.
Собрать и протестировать такую связку под свой сценарий можно бесплатно.
Типичные ошибки при тестировании ИИ-агента
Большинство провалов на запуске это не ошибки агента, а ошибки тестирования: агента проверили не так или не на том. Вот те, что встречаются чаще всего.
Тест на идеальных примерах. Агента гоняют на чистых, удобных заявках и получают отличный результат. В бою приходят заявки с опечатками, без части полей, с нестандартными формулировками, и агент рассыпается. Лечится просто: добавить в выборку реальные «грязные» случаи.
Нет эталона. Прогнали агента, посмотрели ответы, вроде похоже на правду. Без заранее прописанного правильного результата вы не отличите верное действие от правдоподобного. Эталон нужен до прогона, а не после.
Сразу полная автономия. Агенту дают право самому совершать необратимые действия (писать клиенту, менять сделку) с первого дня, без промежуточного контроля. Это самая дорогая ошибка: одна неверная отправка уходит прямо к клиенту.
Полную самостоятельность агенту даём в последнюю очередь, когда уже видно, что он не ошибается на простых задачах. Пока уверенность низкая или цена ошибки высокая, агент должен сначала спросить, потом делать.
Проверяют только модель. Ошибку списывают на «слабую нейросеть» и меняют модель, хотя дело в размытой инструкции или в неподключённом инструменте. Разбор по четырём частям снимает этот вопрос.
Игнорируют журнал. Смотрят только на итоговый результат и не открывают журнал агента. В итоге видят, что агент ошибся, но не понимают где, и правят вслепую.
Тестируют один раз. Прогнали, поправили, запустили. Агент требует итераций: правка инструкции под один тип ошибок иногда ломает поведение на другом. После каждой правки прогон нужно повторять.
Когда агента можно выпускать в прод
Агента можно выпускать, когда на тестовой выборке достигнута заданная метрика и он не совершает необратимых действий без подтверждения человека. Одного ощущения «вроде работает» мало: нужен измеримый критерий, заданный ещё до сборки. Как выбрать такой критерий и вообще подходящего агента под задачу, разобрано в гайде про то, как выбрать ИИ-агента для бизнеса.
Практические критерии готовности к запуску:
- На тестовой выборке из нескольких десятков примеров агент даёт верный результат на подавляющем большинстве, а метрика (например, доля корректно квалифицированных заявок) достигает цели.
- На спорных примерах агент останавливается и передаёт задачу человеку, а не выдумывает данные.
- Необратимые действия (сообщение клиенту, изменение сделки) идут через подтверждение или через тестовую воронку, пока не набрано доверие.
- Журнал агента читается: по нему видно логику каждого решения.
Выпускать лучше поэтапно: сначала на части потока или в режиме, где агент предлагает действие, а решение подтверждает человек. Когда на реальных данных видно, что агент стабилен, долю автономии постепенно повышают. Такой порядок особенно важен там, где цена ошибки высокая, а стоимость запусков считается заранее: как это посчитать, показано в разборе про то, сколько стоит ИИ-агент и когда он окупается.
Если вы поставите агенту чёткую цель, например, доводить клиента до встречи с менеджером, с этой задачей он справится отлично. За пару недель собрали, оттестировали, прогнали на живых примерах, и у вас будет хороший результат.
Собрать агента, прогнать его на своих данных и вывести в работу поэтапно можно в Альбато на бесплатном пробном периоде.
Частые вопросы
Сколько тестовых примеров нужно, чтобы проверить ИИ-агента?
Для большинства сценариев малого бизнеса хватает от 20 до 50 реальных примеров, если в них есть и типовые, и спорные случаи. Важнее не количество, а разнообразие: агент должен встретить на тесте те же «грязные» заявки, что придут в бою. На сложных сценариях выборку увеличивают.
Как понять, что ИИ-агент готов к запуску?
Когда на тестовой выборке достигнута заданная метрика и агент не совершает необратимых действий без подтверждения человека. Формулировка «вроде работает» не подходит: критерий готовности задаётся числом заранее, ещё до сборки агента.
Что делать, если агент ошибается на части документов или заявок?
Сначала разобрать ошибки по четырём частям: чаще всего виновата размытая инструкция, а не модель. Поправьте инструкцию и ограничения, добавьте недостающий инструмент, при необходимости дайте агенту данные компании. После каждой правки повторяйте прогон, потому что изменение под один тип ошибок может задеть другой.
Можно ли тестировать агента, не выпуская его на реальных клиентов?
Да. В Альбато на время теста действия агента направляют в тестовую воронку CRM, отдельную таблицу или тестовый чат, а не в боевую систему. Так вы прогоняете реальные заявки через агента, но клиент ничего не получает, пока связка не проверена.
Чем тестирование ИИ-агента отличается от проверки обычной связки?
Обычная связка всегда делает одно и то же действие, поэтому её проверяют на нескольких примерах и всё. Агент сам выбирает действие в зависимости от данных, поэтому его гоняют на разнообразной выборке и проверяют не только результат, но и логику выбора по журналу.